

MongoDB không chỉ là database: Thiết kế AI Context Layer cho Data Lake và ứng dụng GenAI
Một prototype có thể gọi LLM chỉ bằng vài dòng code. Nhưng khi đưa AI vào production, câu hỏi khó thường không còn là “gọi model nào”, mà là: context đến từ đâu, có đủ mới không, người dùng có quyền xem không, và dữ liệu thay đổi sau lúc tạo embedding thì chuyện gì xảy ra?
Vấn đề cốt lõi của một AI application là đưa đúng dữ liệu, đúng thời điểm, đúng quyền truy cập vào model. MongoDB đáng chú ý trong bài toán này không phải vì nó trở thành một AI model, mà vì lớp operational data có thể mở rộng thành một AI context layer: nơi phục vụ trạng thái hiện tại, metadata, quyền truy cập, search index, vector embedding và state của ứng dụng với độ trễ thấp.
1. Database, Data Lake và AI Context Layer làm ba công việc khác nhau
| Layer | Phù hợp nhất với | Dữ liệu điển hình |
|---|---|---|
| Data lake / lakehouse | lưu trữ lịch sử, batch analytics, training và ETL | raw events, files, dữ liệu lịch sử |
| MongoDB operational/context layer | truy cập ứng dụng độ trễ thấp, trạng thái hiện tại, metadata và retrieval | documents, live state, embeddings, ACL metadata |
| LLM / model layer | reasoning, generation và quyết định gọi tool | prompt/context và model parameters |
Data lake vẫn là nơi phù hợp cho tập dữ liệu thô, lịch sử dài và xử lý phân tích quy mô lớn. LLM chịu trách nhiệm suy luận và sinh nội dung. MongoDB nằm gần application hơn: phục vụ tập dữ liệu đã được chọn lọc, trạng thái thực tế và context có thể truy vấn nhanh.
Vì vậy, đây không phải kiến trúc “thay data lake bằng MongoDB”. Nó là mô hình serving: data lake giữ lịch sử; MongoDB materialize phần dữ liệu ứng dụng cần để đọc, lọc và cập nhật thường xuyên. Có thể xem phạm vi MongoDB cho operational data, Search, Vector Search và AI-ready workloads như các năng lực ghép thành lớp phục vụ này, không phải một tuyên bố rằng mọi workload đều phải dùng MongoDB.

Nguồn: MongoDB — Leveraging an Operational Data Layer for Telco Success.
Sơ đồ trên là một reference pattern: nhiều hệ thống nguồn cấp dữ liệu cho Operational Data Layer, rồi các ứng dụng vận hành, GenAI/analytics và BI sử dụng lớp này. Thành phần cụ thể phải được chọn theo access pattern và constraint thực tế.
2. Bên trong một AI Context Layer có gì?
Một knowledge object có thể giữ nội dung, metadata nghiệp vụ, nguồn gốc, phiên bản và embedding trong cùng document:
{
  "_id": "...",
  "tenantId": "bank-a",
  "entityType": "policy",
  "title": "...",
  "content": "...",
  "status": "active",
  "permissions": ["wealth-advisor", "compliance"],
  "source": {
    "system": "data-lake",
    "objectKey": "...",
    "version": 42
  },
  "updatedAt": "...",
  "embedding": [0.018, -0.027, 0.041]
}
Metadata nằm cạnh dữ liệu retrieval giúp query giới hạn theo tenant, trạng thái, domain, effective date hoặc quyền của user trước khi lấy candidate. Sau retrieval, ứng dụng còn có thể hydrate các field vận hành mới nhất rồi mới xây prompt.
Embedding không phải source of truth. Nó là biểu diễn số được lập index để tìm kiếm. Document nghiệp vụ hoặc nguồn dữ liệu được quản trị vẫn là dữ liệu có thẩm quyền theo data contract của hệ thống. Khi content, embedding model hoặc chunking strategy thay đổi, embedding có thể phải tạo lại.
3. MongoDB nằm giữa Data Lake và AI Application
Operational Systems        Data Lake / Lakehouse
        |                         |
        | CDC / events / ETL      | curated datasets
        +-----------+-------------+
                    |
                    v
        +--------------------------+
        | MongoDB AI Context Layer |
        |--------------------------|
        | Operational documents    |
        | Metadata / ACL           |
        | Search indexes           |
        | Vector embeddings        |
        | Agent/session state      |
        +--------------------------+
                    |
             Retrieval API
                    |
        +-----------+-----------+
        |                       |
        v                       v
   AI Application            AI Agent
        |                       |
        +-----------+-----------+
                    |
                    v
                LLM / FM
Có hai data flow chính.
Historical → operational serving: data lake giữ tập dữ liệu raw và lịch sử lớn. Pipeline chỉ materialize những record đã curated và có ý nghĩa với use case vào MongoDB. Điều này tránh biến serving layer thành bản sao vô điều kiện của toàn bộ lake.
Live operational → AI: thay đổi từ application có thể đi qua events, CDC hoặc streaming. Với thay đổi bên trong MongoDB, Change Streams có thể phát sự kiện cho pipeline downstream. Nhưng Change Streams không tự đồng bộ một data lake bất kỳ; integration vẫn cần connector, idempotency, retry, checkpoint và cơ chế xử lý lỗi.
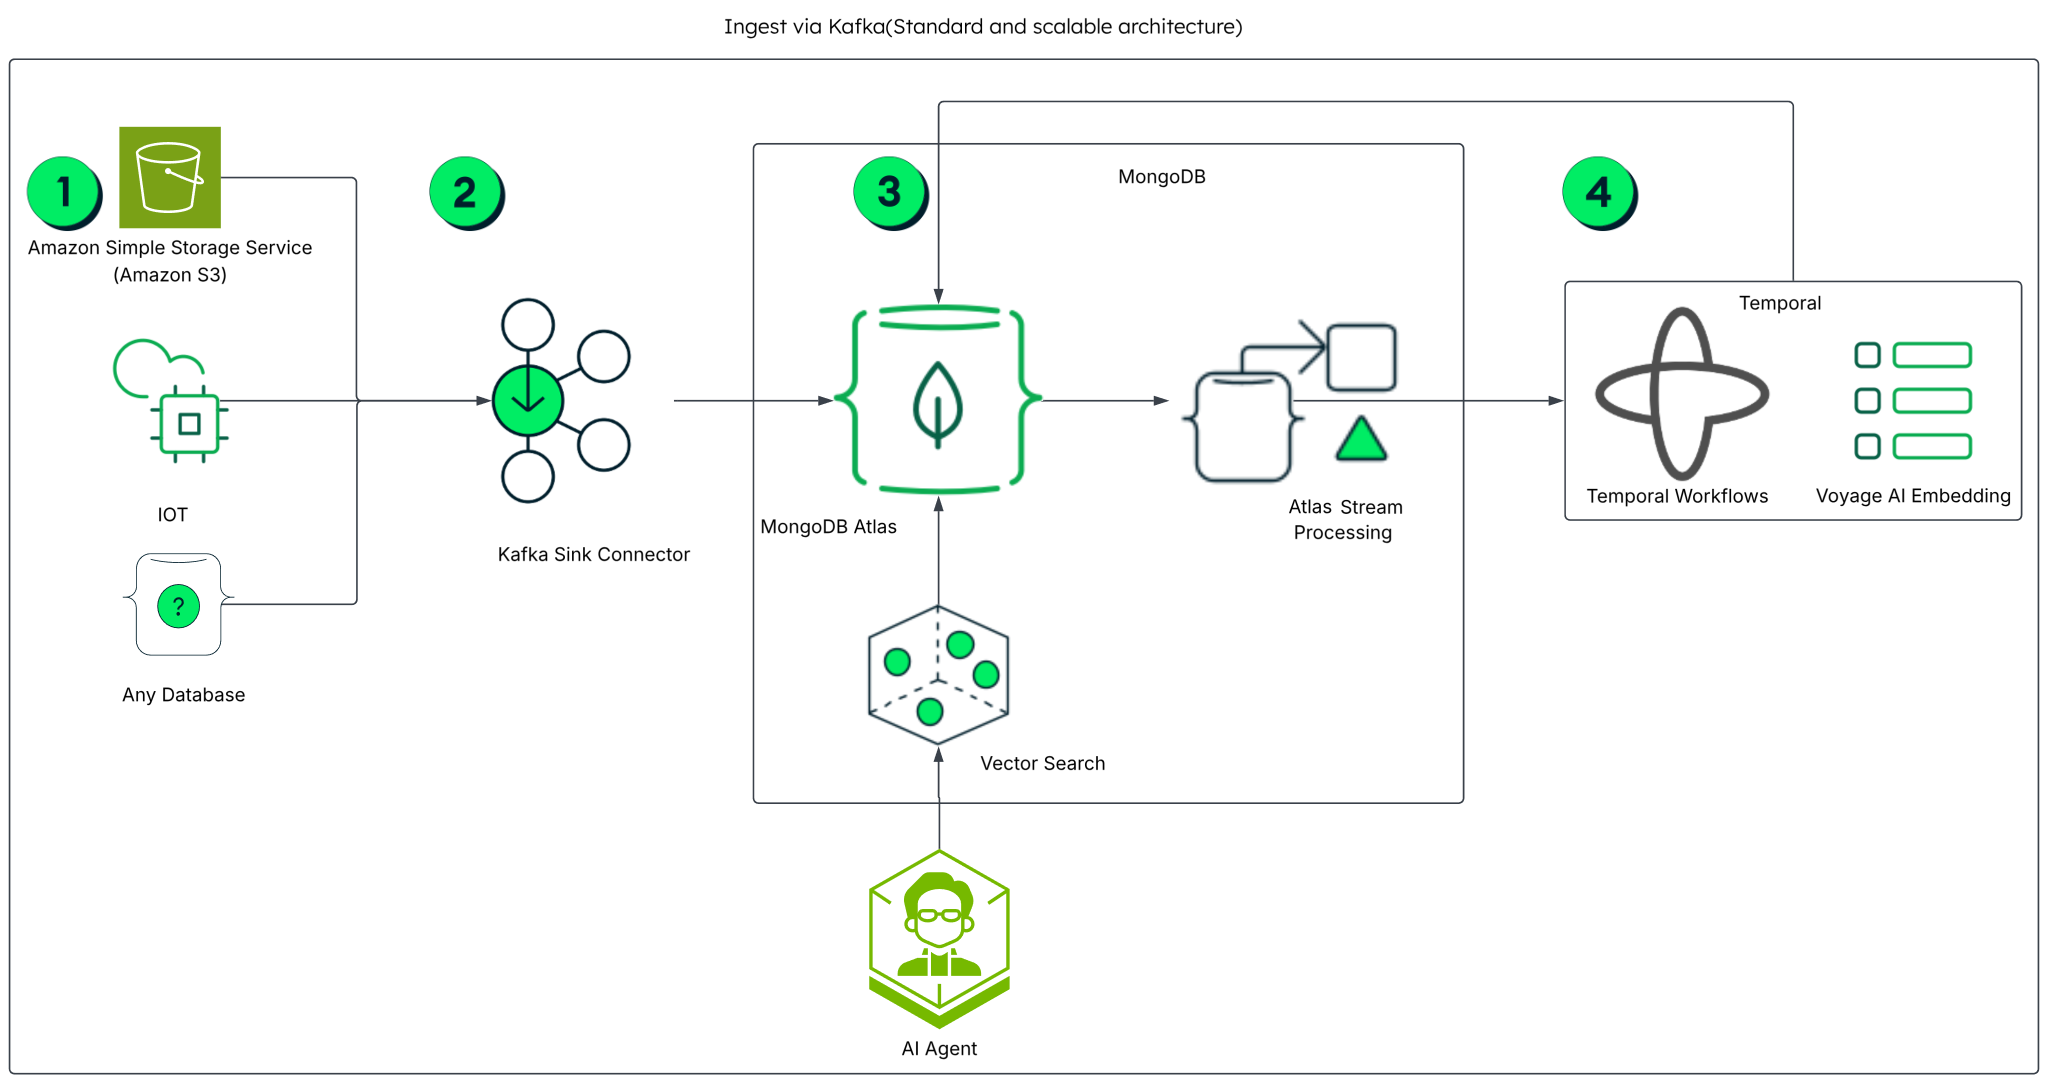
Nguồn: MongoDB Atlas Architecture Center — Building Durable AI Workflows with Temporal and MongoDB Atlas.
Hình này minh họa một implementation có Kafka, Temporal và dịch vụ embedding. Đây là lựa chọn tham khảo, không phải dependency bắt buộc của mọi AI context layer.
4. Production RAG không chỉ là nearest-neighbor search
Một retrieval flow có kiểm soát thường gồm:
- Xác thực caller và xác định tenant/user.
- Resolve permission thành metadata filter có thể thực thi.
- Tạo embedding cho query.
- Chạy vector retrieval với pre-filter.
- Kết hợp lexical và semantic retrieval nếu use case cần.
- Rerank candidate khi lợi ích chất lượng bù được latency/cost.
- Hydrate field hiện tại từ operational record.
- Xây context có giới hạn token và provenance rõ ràng.
- Gọi model, ghi trace/session state phù hợp.
- Đánh giá retrieval và answer quality trên evaluation set.
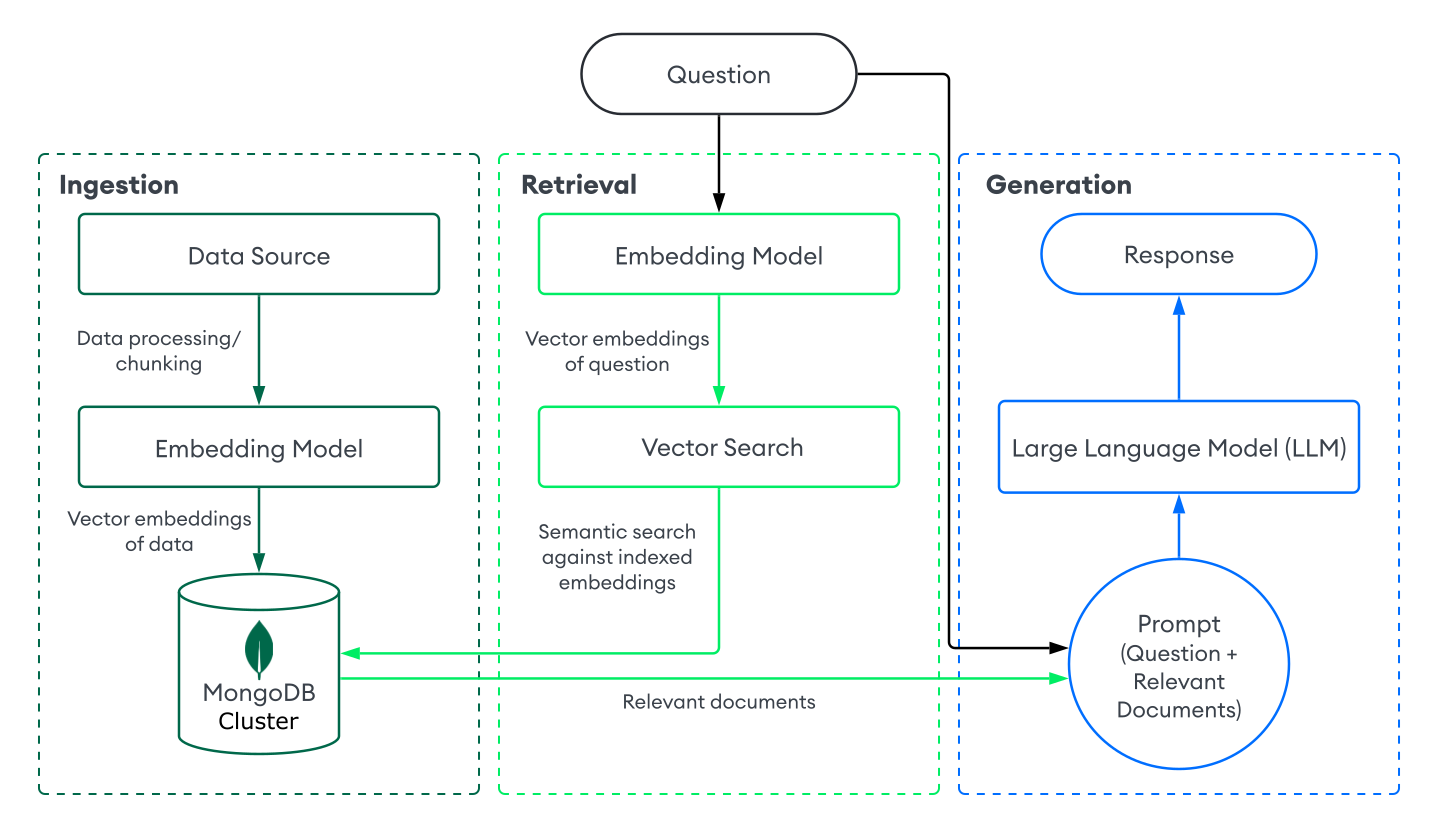
Nguồn: MongoDB Docs — Retrieval-Augmented Generation (RAG) with MongoDB.
Đây là baseline RAG loop. Production system phải bổ sung authorization, freshness, observability, evaluation và index lifecycle.
Ví dụ pipeline Python dưới đây dùng $vectorSearch với filter theo tenant và trạng thái:
pipeline = [
    {
        "$vectorSearch": {
            "index": "knowledge_vector_index",
            "path": "embedding",
            "queryVector": query_embedding,
            "numCandidates": 200,
            "limit": 10,
            "filter": {
                "tenantId": {"$eq": tenant_id},
                "status": {"$eq": "active"}
            }
        }
    },
    {
        "$project": {
            "embedding": 0,
            "title": 1,
            "content": 1,
            "source": 1,
            "updatedAt": 1,
            "score": {"$meta": "vectorSearchScore"}
        }
    }
]
Các field dùng trong filter phải được khai báo phù hợp trong Vector Search index. Quan trọng hơn, semantic similarity không phải authorization model. Application vẫn phải xác thực, resolve quyền và bảo đảm filter không thể bị client bỏ qua.
Vector retrieval hiểu gần nghĩa; lexical/full-text search lại mạnh với mã sản phẩm, tên riêng, số hiệu văn bản, viết tắt và thuật ngữ chính xác. Hybrid retrieval có thể kết hợp hai candidate set rồi fusion/rerank. Ranking là bài toán relevance, không phải security.
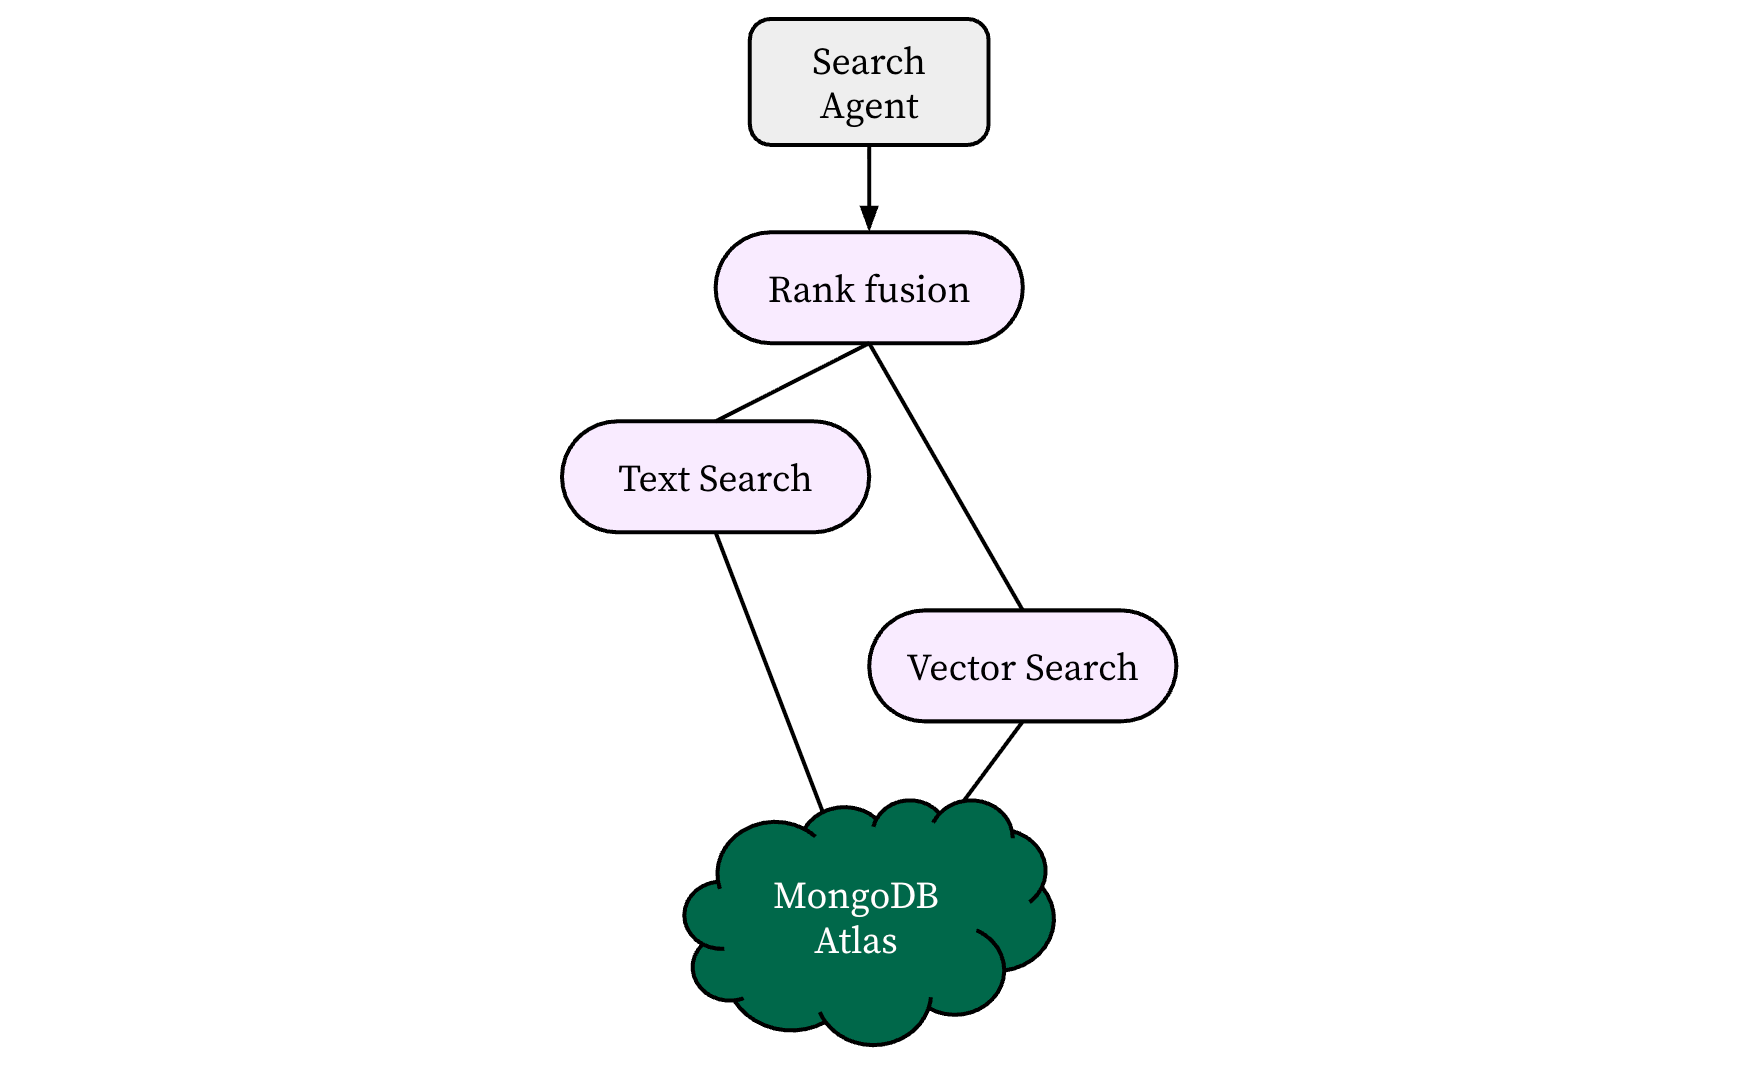
Nguồn: MongoDB — Harness the Power of Atlas Search and Vector Search with $rankFusion.
5. Co-locate operational data và vectors: giảm “synchronization tax”
Kiến trúc tách rời thường có chuỗi App DB → ETL → Vector DB → retrieval service. Mỗi ranh giới tạo thêm trạng thái cần đồng bộ:
- document đã update nhưng vector copy còn cũ;
- record đã xóa vẫn xuất hiện trong search;
- metadata và ACL khác nhau giữa hai store;
- kết quả retrieval phải hydrate lại từ database khác;
- debugging cần correlate ID, version và timestamp qua nhiều hệ thống.
Nếu MongoDB vốn đã phù hợp với operational workload, đặt document, metadata và vector index gần nhau có thể giảm một phần integration overhead. Tuy nhiên nó không loại bỏ đồng bộ: source text đổi thì embedding vẫn cần regenerate; đổi model, vector dimension hoặc chunking strategy có thể cần backfill và rebuild index.
Thiết kế nên có version cho source, chunking và embedding model; ghi nhận trạng thái pending/ready/failed; xử lý update/delete idempotently; và có dead-letter/retry path. Đây mới là khác biệt giữa demo và pipeline vận hành được.
6. AI agent cần state, không chỉ vectors
Agentic application có thể cần conversation/session state, tool invocation history, task checkpoint, user/account state, entity record, retrieved knowledge, event state và long-term semantic memory. Các khái niệm này không nên bị trộn:
- Short-term context: token đang nằm trong prompt/window hiện tại.
- Persistent state: dữ liệu ứng dụng lưu giữa các model call.
- Semantic memory: thông tin được tìm lại dựa trên similarity.
- Authoritative operational state: trạng thái nghiệp vụ thật mà application dùng để ra quyết định.
Document database hữu ích khi các state này có cấu trúc linh hoạt và cần query cùng entity, nhưng retrieval result không được âm thầm thay thế business record có thẩm quyền. Framework có thể đổi; data contract và ranh giới quyền hạn phải ổn định hơn framework.
7. Production concerns quan trọng hơn demo
Freshness và authorization
Cần xác định SLA từ lúc source update đến lúc record, embedding và index có thể query. Pipeline phải xử lý update, delete, duplicate event và indexing delay. Nếu hệ thống eventual consistency, UI và business flow phải chấp nhận rõ khoảng trễ đó.
Tenant isolation và document-level access phải được thực thi bằng architecture của application, database role và metadata filter phù hợp. Không dựa vào câu lệnh trong prompt để bảo vệ dữ liệu.
Retrieval quality và latency
Evaluation set nên chứa query thực tế, expected relevant documents và các ca dễ nhầm. Có thể đo Recall@K, Precision@K, MRR hoặc nDCG tùy bài toán; sau đó đánh giá grounded answer và tác động của false negative. Không có metric nào thay thế được error analysis theo domain.
Latency phải đo end-to-end: embedding, retrieval, reranking, hydration và model call; theo P50/P95/P99 thay vì chỉ trung bình. Một PoC Atlas Vector Search ở quy mô 10 triệu vectors có thể cung cấp ví dụ về latency, throughput, recall, quantization và index lifecycle trong một workload cụ thể, nhưng không thể suy rộng thành benchmark cho mọi schema, hardware hay query distribution.
Index lifecycle, cost và observability
Runbook cần bao phủ initial build, incremental indexing, rebuild khi schema/model đổi, recovery và rollback. Cost không chỉ là database storage: còn có duplicated chunks, vector dimensions, index memory/Search Nodes, embedding calls, reranking và model usage.
Dashboard nên theo dõi retrieval latency, empty-result rate, query distribution, relevance drift, index health, timeout/error rate và tuổi của embedding so với source version. Trace nên nối được query, filter, candidate, score, prompt và answer mà không ghi lộ dữ liệu nhạy cảm.
8. Khi nào kiến trúc này phù hợp — và khi nào không
Đây là lựa chọn đáng cân nhắc khi application đã dùng MongoDB hoặc document-centric operational data; AI cần trạng thái mới; retrieval cần metadata filter phong phú; cần cả lexical lẫn semantic search; agent cần persistent state; và đội ngũ muốn giảm số serving system phải đồng bộ độc lập.
Nó không tự động phù hợp với workload thuần offline analytics trên dữ liệu lịch sử rất lớn, nhu cầu chỉ là archival rẻ, hệ thống không có operational application layer, hoặc một search/vector stack hiện tại đã giải quyết tốt vấn đề. Cũng không nên migrate database chỉ để “có vector search” nếu access pattern không ủng hộ.
Architecture nên bắt đầu từ access pattern và production constraint, không phải từ việc một sản phẩm có nhãn “AI”.
9. PoC thế nào để ra quyết định production?
Một PoC kỹ thuật nên:
- chọn một use case thật và dữ liệu đại diện;
- xác định authoritative source, freshness SLA và access-control rules;
- chọn chunking/embedding strategy, lexical/vector indexes;
- xây evaluation set và benchmark retrieval quality;
- đo end-to-end latency và cost theo tải dự kiến;
- test update, delete, permission change và stale embedding;
- test index build/rebuild, failure và recovery assumption;
- ghi rõ production gap, owner và decision criteria.
Một quy trình PoC MongoDB từ architecture, data model, retrieval testing đến production roadmap nên kết thúc bằng quyết định có bằng chứng: tiếp tục, điều chỉnh hoặc dừng — không phải bằng một demo đẹp nhưng thiếu dữ liệu vận hành.
Kết luận
MongoDB vẫn là database, nhưng trong AI architecture vai trò của nó có thể vượt ra ngoài persistence. Khi operational documents, metadata, search, vectors và application state được phục vụ qua một governed data layer, MongoDB có thể trở thành context layer thực dụng cho RAG, AI agent và intelligent application.
Giá trị không nằm ở việc “có vectors”, mà ở khả năng giữ retrieval gần với trạng thái operational hiện tại, có quyền truy cập rõ ràng và đo lường được. Trong production AI, model có thể thay đổi rất nhanh; data contract, retrieval quality và operational state mới là phần kiến trúc phải sống lâu.
All rights reserved
